前回、特徴量抽出では、画像から特徴量を検出し、それを画像識別に利用する方法を見てきた。
2000年台まで、画像識別の分野では、画像を如何に特徴化するかと得られた特徴からどのように物体を認識するかという二つの研究が中心となってきた。
そのために、SIFTを始めとする特徴量の改善や、カーネル法を用いたSVMの性能改善などが試みられてきたが、その性能は徐々に頭打ちになっていく。
そんな折、彗星のごとく現れた技術がニューラルネットワークを多層化した深層学習である。実は、ニューラルネット自体は人間の脳のシナプス同士の結合を模したモデルとして1950年代から研究されていた。
最初にニューラルネットが日の目を見たのは1980年代で、この頃には、入力層、隠れ層、出力層の三層を持つニューラルネットがある程度の性能を出せることが知られていた。当然ながら、その当時も、より多層のニューラルネットワークを利用しようという考え自体はあり、検討が試みられたが、ニューラルネットワークの持つ多数のパラメータを上手く最適化する手法がなく、その時代には実現が難しいと考えられていた。
なお、多層のニューラルネットの考え方を最初に提唱したのは、当時NHKの放送技術研究所の研究員であった福島邦彦氏であるとされており、その論文は、驚くべきことに1980年に出版されている Fukushima (1980)。方向性は異なるものの、これは2024年にノーベル物理学賞を獲得したGeoffrey Hinton氏の代表研究である誤差逆伝搬の論文Rumelhart et al. (1986)や、John Hopfield氏のHopfieldネットワークHopfield (1982)の論文よりも前の研究である。
2010年代に入ると、それまで下火だったニューラルネットが再び注目を集めることになる。それまで細々と続けられていたニューラルネットワークの研究の中で、パラメータの過学習や、最適化時の勾配消失といった問題が徐々に解決されるとともに、GPUを用いた汎用計算であるGPGPU (General Purpose Computing on GPU)により並列計算の効率が大幅に向上するなど、ニューラルネットワークを取り巻く環境が徐々に変化してくる。
そして、2012年に深層学習を一躍有名にする出来事が起こる。
ImageNetと呼ばれる大規模画像データセットの識別チャレンジであるILSVRC (ImageNet Large Scale Visual Recognition Challenge)において、トロント大学のGeoffrey Hintonらの研究チームが、AlexNet (筆頭著者のfirst nameから)と呼ばれる二股のニューラルネットを用いて、2位のエラー率26.2%に大差をつけ、エラー率わずか17.0%を達成し、優勝する Krizhevsky et al. (2012)。この時の2位のチーム(東京大学のチーム)が用いた手法はSIFT, Fisher Vector, SVMを組み合わせたものであった。
この優勝を皮切りに、2013年の大会ではオックスフォード大学のチームがVGGというネットワークで2位に入り、以後、2014年はGoogleのチームがGoogLeNetというネットワークで2位、2015年はMicrosoftのチームがResNetというネットワークで優勝する。
こうして、2016年くらいになると、現在のニューラルネットワークの構築において一般的になっている諸技術、例えば、
Rectified Linear Unit (ReLU)
Max Pooling
Dropout
Batch Normalization
Skip Connection (Residual Block)
Adaptive Moment Estimation (Adam)
などの技術が、一通り出そろう。
さらには、この頃になるとNVIDIAのCaffeや、モントリオール大学のtheano、FacebookのTorch、そしてPreferred NetworkのChainerといった汎用の深層学習用ライブラリが多数登場する。これによって、深層学習の研究が一気に花開き、現在に至る。
本章では、深層学習のモデルを実際に構築する前段階として、深層学習のフレームワークであるPyTorchの基本的な使い方を学ぶ。具体的には、PyTorchにおけるデータの表現であるテンソルの扱い方と、パラメータの最適化を支える自動微分の仕組み、そして自動微分を利用した最適化の方法について順に見ていく。
実際にニューラルネットワークを構築し、画像を識別するモデルを学習させる手順については、次章の深層学習による画像識別で扱う。
Google Colab用の準備
Source
IN_COLAB = True
try:
    import google.colab

    print('You are running the code in Google Colab.')
except ImportError:
    IN_COLAB = False
    print('You are running the code in the local computer.')

if IN_COLAB:
    # PyTorchのインストール
    !pip install torch torchvision
    pass
You are running the code in the local computer.
10.1PyTorchの基本
本章では、数ある深層学習のフレームワークのうち、研究開発目的に最も一般的に使用されていると思われるPyTorchを扱う。
PyTorchには、いくつかのモジュールが用意されており、代表的なものが、
torchtorch.nntorch.nn.functional
の3つである。慣例的に、これらをこのような形でエイリアスを与えてインポートする。
# PyTorchのモジュール群
import torch
import torch.nn as nn
import torch.nn.functional as Ftorchモジュールがテンソルデータそのもの(torch.Tensor等)や、データに対する操作 (torch.expやtorch.transpose等)が含まれる。
torch.nnモジュールには、ニューラルネットワークを構成するレイヤー (nn.Linearやnn.Conv2d等)や損失関数 (nn.CrossEntropyLossやnn.MSELoss等)が含まれる。
torch.nn.functionalモジュールには、torch.nnモジュールに含まれるクラス定義に対応する関数が用意されている。例えばnn.Linearに対応する関数としてF.linear、nn.MSELossに対応する関数としてF.mse_loss、といった具合である。
また、インストールすることは必須ではないが、PyTorchに付属するライブラリにTorchVisionがある。TorchVisionは、主にコンピュータ・ビジョンへの応用を目的とした補助関数が多数用意されている。
これ以外にも、有名ネットワークモデルの学習済み重みなどが提供されており、AlexNetやResNet50等のほか、ViTなどの比較的新しいものも含まれている。
本資料では、画像の前処理に使うtransformsモジュールだけを用いる (使用方法については後述する)。
torch.Tensor
PyTorchの中で変数を扱う場合、スカラーであってもベクトルであっても、はたまた行列であっても、共通でtorch.Tensorという型を用いる。これは、NumPyのnp.arrayとほとんど同じように使うことができる。
初期化をする方法には、いくつかあるが、大きく分けて、
torch.Tensorのコンストラクタを呼び出すtorch.tensor関数を用いてTensorを作るNumPyの配列を最初に用意して
torch.from_numpy関数を使う
の3つの方法がある。順に見ていこう。
torch.Tensorを使う
まず、torch.Tensor型のコンストラクタを用いて初期化する場合を見ていく。この場合、コンストラクタの引数にPythonやNumPyの配列を指定して初期化する。
この時、配列がどのような型であっても、PyTorchのdefault_dtypeに指定された型 (初期値はfloat32)の型にキャストされる。
x_npy = np.arange(10)
print("NumPy's dtype:", x_npy.dtype)
x = torch.Tensor(x_npy)
print("Torch's dtype:", x.dtype)
NumPy's dtype: int32
Torch's dtype: torch.float32
このように、NumPyの配列としての型はint64型であるにも関わらず、torch.Tensorを用いることで、型がfloat32に変更されていることが分かる。なお、この初期の型はtorch.set_default_dtypeで変更することもできる。
# 初期の型を64bit浮動小数に変更
torch.set_default_dtype(torch.float64)
x = torch.Tensor(x_npy)
print("Torch's dtype:", x.dtype)

# 元に戻しておく
torch.set_default_dtype(torch.float32)
Torch's dtype: torch.float64
torch.tensorを使う
次にtorch.Tensor型のインスタンスを作成する関数であるtorch.tensorを用いる場合を見ていく。
本関数はtorch.Tensorと名前が似ており、非常に紛らわしいが、torch.Tensorはコンストラクタであり、torch.tensorは初期化用のユーティリティ関数である。
使い方も非常に似ており、torch.tensorにも、PythonやNumPyの配列を指定してtorch.Tensor型の多次元配列を作ることができる。
x_npy = np.arange(10)
x = torch.tensor(x_npy)
print("Torch's dtype:", x.dtype)
Torch's dtype: torch.int32
torch.tensorは先ほどとは異なり、PythonやNumPyの配列で定義されている要素の型を引き継ぐ。そのため、上記の例ではtorch.Tensorのdtypeがint64になっている。また、torch.tensor関数は、型を指定してtorch.Tensorを作ることもできる。
x = torch.tensor(x_npy, dtype=torch.float32)
print("Torch's dtype:", x.dtype)
Torch's dtype: torch.float32
また、詳細については後述するが、PyTorchの自動微分の機能を使うために必要なrequires_gradパラメータを指定することもできる。
x = torch.tensor(x_npy, dtype=torch.float32, requires_grad=True)
print(x)
tensor([0., 1., 2., 3., 4., 5., 6., 7., 8., 9.], requires_grad=True)
このようにtorch.tensor関数はtorch.Tensorのコンストラクタを呼び出す場合と比べて圧倒的に使い勝手が良い。
従って、プログラマ自身が型を管理することに抵抗がないのであれば、torch.tensor関数を使うのが良いだろう。
torch.from_numpy
最後にNumPyの配列からtorch.Tensor型のインスタンスを作成するtorch.from_numpyを用いる場合を見ていく。
torch.from_numpy関数もtorch.Tensorと仕様はかなり似ているが、
引数としてNumPyの配列しか取ることができない
dtypeはNumPyのものを引き継ぐ
の2点が大きく異なる。
x_npy = np.arange(10)
x = torch.from_numpy(x_npy)
print("Torch's dtype:", x.dtype)
Torch's dtype: torch.int32
またtorch.from_numpyは元のNumPyの配列とデータを共有しており、元の配列の値を書き換えるとそれが反映されるという違いがある。
# torch.Tensorの場合
x_npy = np.arange(10)
x = torch.Tensor(x_npy)
print('Before:', x)
x_npy *= 2
print(' After:', x)
Before: tensor([0., 1., 2., 3., 4., 5., 6., 7., 8., 9.])
After: tensor([0., 1., 2., 3., 4., 5., 6., 7., 8., 9.])
# torch.from_numpyの場合
x_npy = np.arange(10)
x = torch.from_numpy(x_npy)
print('Before:', x)
x_npy *= 2
print(' After:', x)
Before: tensor([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=torch.int32)
After: tensor([ 0, 2, 4, 6, 8, 10, 12, 14, 16, 18], dtype=torch.int32)
この違いを意識すべき場面は少ないが、時に問題が生じることがあるので、特段の理由がない限りはtorch.tensorを使う方が、多くの場合で問題を引き起こす危険性が低いだろう。
torch.Tensorからの値の取り出し
またtorch.Tensor型で何らかの演算を行った後で、それをPythonやNumPyの配列に戻したいと思うこともあるだろう。この場合には、Pythonの配列ならtolist関数、NumPyの配列ならnumpy関数を用いる。
x = torch.arange(10)

# Pythonの配列に直す
x_list = x.tolist()
print('Type:', type(x_list))
print(x_list)

# NumPyの配列に直す
x_npy = x.numpy()
print('Type:', type(x_npy))
print(x_npy)
Type: <class 'list'>
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Type: <class 'numpy.ndarray'>
[0 1 2 3 4 5 6 7 8 9]
また、配列の値が1つである場合に限り、item関数を使って、その1つの値をPythonの数値型として取り出すこともできる。このitem関数は、要素が2つ以上ある配列に対して呼び出すと例外が発生するので注意すること。
x = torch.tensor([1.0], dtype=torch.float32)
print(x.item())
1.0
10.2自動微分
深層学習を支える重要な技術に自動微分がある。関数の微分は、損失関数の最小化といった最適化問題にとって重要な情報であり、例えば、最急降下法やニュートン法といったアルゴリズムは、それぞれ関数の1階微分 (勾配)と、2階微分 (Hesse行列)を用いる。
しかし、このような微分を求めるには、数学的に関数の微分を求めておく必要があり、特に関数が複雑な場合には、それを求めることは困難である (従来はMathematicaなどのソフトを使って、勾配を求めるコードを書き出していた)。
また、1階微分であれば、差分法によって近似をすることも可能ではあるが、数値精度の問題は残る。2階微分以上になると差分計算の誤差が蓄積していくため、数値的に満足な結果を得ることは非常に難しくなる。
自動微分の仕組み
自動微分は、プログラム的に、とある演算とその微分計算がペアとして定義されており、演算の列によって表される関数の微分は、各演算の微分から、合成関数の微分としての連鎖律 (chain rule)により計算される。
一例として、ここでは、
の微分を例にとって見てみよう。
ここで、, とすると、はとの合成関数としてと表せる。言うまでもなく、の微分は、との微分を用いて、
となる。ここで注目してほしいのは、を計算する際の計算順序が、
の値が与えられる
の値を計算する
の値を計算する
となっているということである。の微分を計算するときには、この逆順に、
のに関する微分としてが与えられる
既知のからを計算する
既知のからを計算する
という流れになっている。従って、各演算において、
演算の入力を保持しておく
演算の導関数を定義しておく
という準備をしておけば、最終出力のに関する微分が与えられれば、連鎖律を用いてが求まる、という訳である。
自動微分の利用
では、上記の議論をPyTorchを用いて実験してみる。前述の通り、torch.tensor関数にrequires_gradパラメータを指定することで、自動微分により勾配が計算される変数を作ることができる。
# 変数を作成
x = torch.tensor([2.0], requires_grad=True)なお、一度、作成したTensorに対して自動微分を有効にしたい場合にはrequires_grad_関数にTrueを渡す。
x = x.requires_grad_(True)それでは、ここで定義したを用いて変数を用いて、を段階的に計算してみる。
# y = g(x) = x^2の計算
y = x * x
print(f'y = g(x) = {y.item():.1f}')

# z = cos(y)の計算
z = torch.cos(y)
print(f'z = h(y) = {z.item():.5f}')
y = g(x) = 4.0
z = h(y) = -0.65364
最終的なのに関する微分を求めるには、z.backward()という関数を呼び出せば良い。ただし、この関数はスカラーの出力にしか使えないので注意が必要。
# 微分の計算
z.backward()すると、予め自動微分を有効にしておいた変数にはgradというメンバが追加され、そこに微分の値が代入される。なお、backward関数は、デフォルトでは、一度呼び出すと同じ変数に対して再度呼び出すことはできないようになっている(メモリをできるだけ削減するため)。
同じ関数に対して、何度もbackwardを呼び出したい場合には、backward関数のパラメータにretain_graph=Trueを渡すこと (例外のメッセージにも同様のことが書かれている)。
try:
    z.backward()
except Exception as e:
    print('Exception:', e)
Exception: Trying to backward through the graph a second time (or directly access saved tensors after they have already been freed). Saved intermediate values of the graph are freed when you call .backward() or autograd.grad(). Specify retain_graph=True if you need to backward through the graph a second time or if you need to access saved tensors after calling backward.
dzdx_autograd = x.grad
print(f'autograd: dz/dx = {dzdx_autograd.item():.5f}')

dzdx_analytic = -2.0 * x * torch.sin(x * x)
print(f'analytic: dz/dx = {dzdx_analytic.item():.5f}')
autograd: dz/dx = 3.02721
analytic: dz/dx = 3.02721
以上から、自動微分によって、正しく演算の微分が計算できていることが確認できた。
上記と同等の計算は、単に入力となっているに関する勾配を求めたいだけであれば torch.autograd.gradを用いて、以下のように書くこともできる。なお、torch.autograd.grad関数の戻り値は、配列になっているので注意すること。
x = torch.tensor([2.0], requires_grad=True)
z = torch.cos(x * x)
dzdx = torch.autograd.grad(z, inputs=x)
print(f'autograd.grad: dz/dx = {dzdx[0].item():.5f}')
autograd.grad: dz/dx = 3.02721
勾配計算の制御
自動微分を実際に使う上では、勾配の計算を制御するための仕組みを3つ知っておく必要がある。いずれも、この後のニュートン法やオプティマイザの実装、そして次章の学習ループで実際に使うものである。
勾配の累積
backwardによって計算された勾配は、gradに代入されるのではなく加算される。そのため、同じ変数に対してbackwardを複数回呼び出すと、勾配が足し合わされていく。
x = torch.tensor([2.0], requires_grad=True)
for i in range(3):
    z = torch.cos(x * x)
    z.backward()
    print(f'{i + 1}回目のbackward後: x.grad = {x.grad.item():.5f}')
1回目のbackward後: x.grad = 3.02721
2回目のbackward後: x.grad = 6.05442
3回目のbackward後: x.grad = 9.08163
これは、複数の損失関数から得られる勾配を足し合わせたい場合などには便利な仕様である。一方、通常の最適化では、各ステップで勾配を計算し直したいので、その都度、勾配をゼロに戻す必要がある。
x = torch.tensor([2.0], requires_grad=True)
for i in range(3):
    if x.grad is not None:
        x.grad.zero_()  # 勾配をゼロに戻す

    z = torch.cos(x * x)
    z.backward()
    print(f'{i + 1}回目のbackward後: x.grad = {x.grad.item():.5f}')
1回目のbackward後: x.grad = 3.02721
2回目のbackward後: x.grad = 3.02721
3回目のbackward後: x.grad = 3.02721
後述するオプティマイザを使う場合には、この処理がoptim.zero_grad()として用意されている。深層学習の学習ループで、毎回zero_gradが呼ばれているのは、このためである。
計算グラフからの切り離し
requires_grad=Trueである変数から計算された値は、自動微分のための計算グラフを保持している。この計算グラフが不要な場合、例えば、計算結果をNumPyの配列に変換して図に描きたい場合などには、detachを用いて計算グラフから切り離す。
x = torch.tensor([2.0], requires_grad=True)
z = torch.cos(x * x)

try:
    z.numpy()
except Exception as e:
    print('Exception:', e)

print('detachしてから:', z.detach().numpy())
Exception: Can't call numpy() on Tensor that requires grad. Use tensor.detach().numpy() instead.
detachしてから: [-0.6536436]
detachは、元のtorch.Tensorとメモリを共有しつつ、計算グラフを持たない新しいtorch.Tensorを返す。
勾配計算の無効化
学習済みのモデルを使って予測をするときのように、そもそも勾配が必要ない場合には、torch.no_grad()のブロックの中で計算を行うことで、計算グラフの構築自体を省略できる。これにより、計算に必要なメモリが削減され、計算も多少高速になる。
x = torch.tensor([2.0], requires_grad=True)

z = torch.cos(x * x)
print('通常     :', z.requires_grad)

with torch.no_grad():
    z = torch.cos(x * x)
    print('no_grad内:', z.requires_grad)
通常 : True
no_grad内: False
二階微分の計算
続いて、前述のの二階微分の計算を自動微分で行ってみる。
実は、自動微分を使えば、高階微分を計算することも容易で、二階導関数を求めたい場合、一階導関数の計算中に計算グラフを遡っていく計算に対して、別の計算グラフを構築すれば良い。この計算グラフを再度遡って微分を求めることで二階微分が求まる、というわけである。
例えば、先ほどの計算であれば、連鎖律の途中で、の計算やの計算が発生していたが、これらの計算について、途中結果を保存し、その微分計算が行えるように計算グラフを構築することができる。なお、二階微分を計算するときにはbackward関数の代わりに、torch.autograd.gradを使わないと警告メッセージが出るので注意すること (計算自体はできる)。
x = torch.tensor([2.0], requires_grad=True)
y = x * x
z = torch.cos(y)

# 1階微分を計算しつつ, 新たな計算グラフを作成
dzdx = torch.autograd.grad(z, inputs=x, create_graph=True)

# 2階微分を計算
ddz_ddx_auto = torch.autograd.grad(dzdx, inputs=x)
ddz_ddx_analy = -2.0 * torch.sin(x**2.0) - 4.0 * x**2.0 * torch.cos(x**2)
print(f'autograd: ddz_ddx = {ddz_ddx_auto[0].item():.5f}')
print(f'analytic: ddz_ddx = {ddz_ddx_analy.item():.5f}')
autograd: ddz_ddx = 11.97190
analytic: ddz_ddx = 11.97190
このように、二階微分の場合も正しく計算できていることが分かる。以後、より高階な微分であってもtorch.autograd.gradの引数でcreate_graph=Trueを指定する限りは計算し続けることができる。
多変数関数の微分
続いては、変数が2つ以上の場合の微分 (勾配)について見てみる。今回は例としてRosenbrock関数と呼ばれる、以下の関数について微分を計算してみる。
この関数において, とするとして、二次元平面上に値をプロットすると以下のようになる (カラーバーは対数の値に対して計算されている)。
Source
from matplotlib.colors import LogNorm

xs = np.linspace(-2.0, 2.0, 200)
ys = np.linspace(-1.0, 3.0, 200)
xs, ys = np.meshgrid(xs, ys)
extent = (-2.0, 2.0, -1.0, 3.0)
rosen = (1.0 - xs) ** 2.0 + 100.0 * (ys - xs**2.0) ** 2.0

fig, ax = plt.subplots()
mappable = ax.imshow(np.flip(rosen, axis=0), cmap='viridis', extent=extent, norm=LogNorm(vmin=1e-4, vmax=1.0e4))
ax.set(title='Rosenbrock function')
ax.contour(xs, ys, rosen, colors=['white'], linewidths=[0.5], norm=LogNorm(vmin=1e-4, vmax=1.0e4))
ax.scatter([1.0], [1.0], s=50, marker='o', color=color_palette[1], zorder=100)
fig.colorbar(mappable, ax=ax)
plt.show()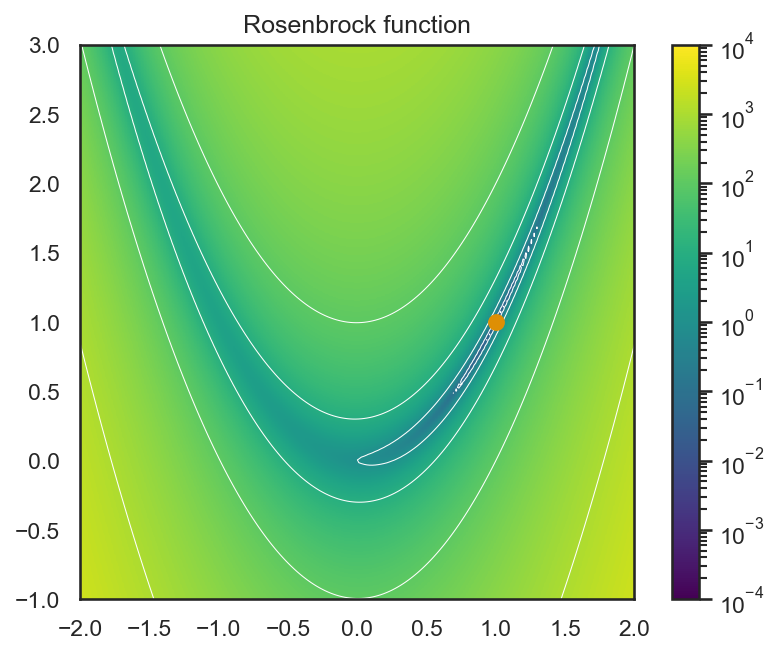
この関数は、の点を打った場所が関数の最小値をとる箇所になっているのだが、最小値の近傍が非常に狭い谷のような形になっており、さらにその谷が放物線上に湾曲しているため、この赤点の位置の最小値を求めることが困難であるとされている。
まずはとして、Rosenbrock関数自体の値を計算してみる。
x = torch.tensor([0.0, 0.0], requires_grad=True)
f = (x[0] - 1.0) ** 2.0 + 100.0 * (x[1] - x[0] ** 2.0) ** 2.0
print(f'f(0, 0) = {f.item():f}')
f(0, 0) = 1.000000
次に、単一の変数の場合と同様に、出力のfに対してbackwardを呼び出して、 (上記のコードではxの0番目と1番目の要素に対応)に関する微分を求める。
f.backward()
print(f'df/dx at (0, 0) = {x.grad.tolist()}')
df/dx at (0, 0) = [-2.0, 0.0]
続いては、Rosenbrock関数の二階導関数としてのHesse行列 (Hessianとも言う)を求めてみる。この場合は、先ほどの1変数の場合よりは多少工夫が必要になる。
まずは、fに対してtorch.autograd.gradを計算する。
x = torch.tensor([0.0, 0.0], requires_grad=True)
f = (x[0] - 1.0) ** 2.0 + 100.0 * (x[1] - x[0] ** 2.0) ** 2.0
grad = torch.autograd.grad(f, inputs=x, create_graph=True)安直には、このgradに対して、もう一度torch.autograd.grad関数を適用すれば良さそうだが、前述の通りbackward関数やtorch.autograd.grad関数は、出力がスカラーでない場合には使うことができない。
try:
    H = torch.autograd.grad(grad, inputs=x)
except Exception as e:
    print('Exception:', e)
Exception: grad can be implicitly created only for scalar outputs
従って、ここで計算に一工夫が必要になる。ここで連鎖律の計算を思い出してほしい。連鎖律を計算するとき、スカラー値スカラー関数の場合には、から、連鎖律が始まり、その前の計算の微分を順に乗していくことで最終的な入力変数に関する微分を計算していたのであった。
この理屈で言えば、出力が二次元ベクトルであるような関数において、連鎖律のスタートとなるべき値は
の2つとなることに気づく。前者を指定すれば勾配ベクトルの第1成分 の微分が、後者を指定すれば第2成分 の微分が計算され、それぞれがHesse行列の第1行、第2行に対応する。そこで、このそれぞれを連鎖律のスタートとしてgrad_outputsパラメータに指定してtorch.autograd.gradを呼び出してみる。
ddf_dxx = torch.autograd.grad(grad, inputs=x, grad_outputs=torch.tensor([1.0, 0.0]), retain_graph=True)[0]
ddf_dyy = torch.autograd.grad(grad, inputs=x, grad_outputs=torch.tensor([0.0, 1.0]), retain_graph=True)[0]
H = torch.stack([ddf_dxx, ddf_dyy], axis=0)print(H)tensor([[ 2., 0.],
[ 0., 200.]])
10.3ニュートン法の実装
それでは、ここで練習としてニュートン法を用いてRosenbrock関数の最小値を求めてみよう。ニュートン法は、Hesse行列と、の勾配を用いて、
のように更新幅を計算するような、繰り返し最適化法の一種である。これは、関数の周りのTaylor展開により、
となることから説明できる。この式を変形すると、
という式が得られる。従って、Taylor展開の第2項までで元の関数を近似した範囲においては、となるような場所、すなわち だけ移動した場所に移ることで、関数の最小値に近づくことができる (これは、関数を局所的に二次関数で近似して、その二次関数の「底」に移動することに対応する)。
実際には、最小化すべき関数が局所的に二次関数で近似できることばかりではないので、通常は(8)で求まった に小さな定数を乗じての値を
のように更新することが多い。(8)の は符号を除いた更新幅であるため、上式では引き算になっていることに注意してほしい (この後のコードでx = x - 0.5 * dxとしているのは、このためである)。
では、ここまでの議論を踏まえて、実際に自動微分により求めたHesse行列を用いてRosenbrock関数を最小化してみよう (以下にコードと実行結果を示すが、まずは自分自身で考えてみてほしい)。
def rosenbrock(x):
    """Rosenbrock function"""
    return (x[0] - 1.0) ** 2.0 + 100.0 * (x[1] - x[0] ** 2.0) ** 2.0
initial_x = np.array([-1.0, 1.5])
def calc_newton_step(f, x):
grad = torch.autograd.grad(f, inputs=x, create_graph=True)[0]
gx = torch.autograd.grad(
grad,
inputs=x,
grad_outputs=torch.tensor([1.0, 0.0]),
retain_graph=True,
)[0]
gy = torch.autograd.grad(
grad,
inputs=x,
grad_outputs=torch.tensor([0.0, 1.0]),
retain_graph=True,
)[0]
H = torch.stack([gx, gy], axis=0)
return torch.linalg.solve(H, grad)
x = torch.tensor(initial_x, requires_grad=True)
pts = []
for i in range(100):
pts.append(x.detach().numpy())
fx = rosenbrock(x)
dx = calc_newton_step(fx, x)
x = x - 0.5 * dx
x = x.detach().requires_grad_(True)
print('The answer is:', x.detach().numpy())The answer is: [1. 1.]
Source
from matplotlib.colors import LogNorm

xs = np.linspace(-2.0, 2.0, 200)
ys = np.linspace(-1.0, 3.0, 200)
xs, ys = np.meshgrid(xs, ys)
extent = (-2.0, 2.0, -1.0, 3.0)
rosen = (1.0 - xs) ** 2.0 + 100.0 * (ys - xs**2.0) ** 2.0

fig, ax = plt.subplots()
mappable = ax.imshow(np.flip(rosen, axis=0), cmap='viridis', extent=extent, norm=LogNorm(vmin=1e-4, vmax=1.0e4))
ax.set(title='Rosenbrock function')
ax.contour(xs, ys, rosen, colors=['white'], linewidths=[0.5], norm=LogNorm(vmin=1e-4, vmax=1.0e4))
ax.scatter([1.0], [1.0], s=50, marker='o', color=color_palette[1], zorder=100)
ax.scatter(initial_x[0], initial_x[1], s=50, marker='o', color=color_palette[3], zorder=100)

# 軌跡のプロット
pts = np.array(pts)
ax.plot(pts[:, 0], pts[:, 1], color=color_palette[8], marker='o', markersize='3.0', linewidth=1.0)

fig.colorbar(mappable, ax=ax)
plt.show()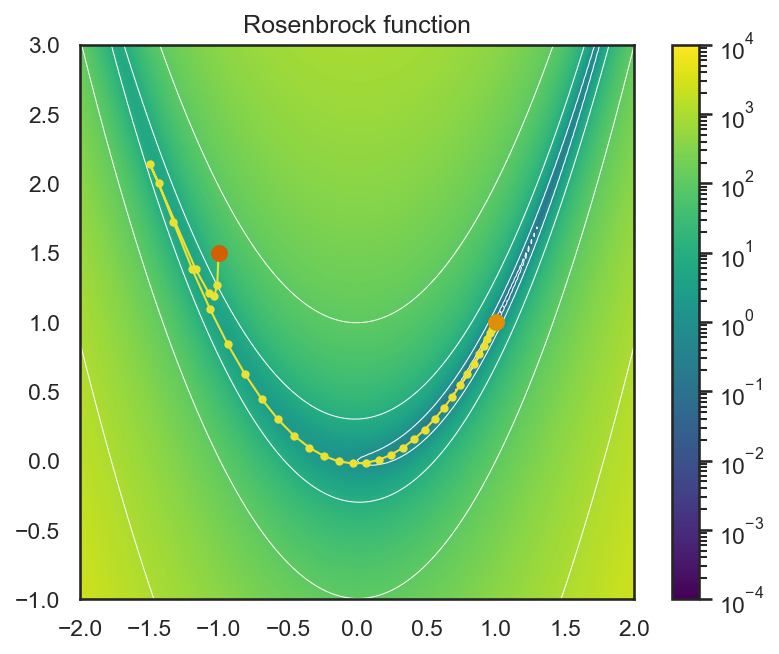
この図では、の初期値からの最小値に至るまでの最適化の過程をマーカー付きの曲線で示している。各マーカーの位置を見てみると、徐々に最小値に至るスピードが遅くなりつつも、正しく関数の最小値を取る箇所に収束していることが分かる。
Rosenbrock関数の最小化については、解の初期値やニュートン法のステップ幅を変化させることで、収束が不安定になって最小解からはずれて・近づいてを繰り返すような軌跡を描くこともある。ぜひ、いろいろなパラメータで軌跡を描画して、その性質の理解に努めて欲しい。
10.4オプティマイザによる最適化
PyTorchにはオプティマイザというモジュールが用意されており、一階微分量を用いる最急降下法を対象として、さまざまなアルゴリズムが提供されている。ニューラルネットワークの訓練においては、確率的に選ばれたミニバッチから、パラメータを更新する勾配を求めるので、モジュールの名前としては確率的最急降下法 (SGD = stochastic gradient descent)を基本としたものとなっている。
確率的最急降下法
最も単純な確率的最急降下法では、誤差関数を、パラメータを、更新のステップ幅 (=更新率)をとして、パラメータを以下の式で更新する。
しかし、単純な確率的最急降下法はパラメータの更新方向が安定しないという問題があり、モメンタム(慣性)を使って、急激に勾配方向が変わらないように移動平均を取るアルゴリズム (Momentum SGD)もある。Momentum SGDの更新式は以下の通り (参照)。
このように、慣性パラメータとして ()を導入することで、過去の更新方向を一定の割合で残しつつ、パラメータの更新を行う。
RMSprop
最急降下法のもう一つの問題に解の振動が挙げられる。これはパラメータ更新のステップ幅が大きすぎるために、谷のような形状の両岸を行ったり来たりしてしまうような現象である。当然、ステップサイズを小さくすればその影響は抑えられるが、その分、最適化の収束は遅くなってしまう。
このような振動の問題を防ぐアルゴリズムの一つにRMSprop (root-mean-square propagation)がある。RMSpropは、その名前にある通り、勾配の二乗平均平方根を取り、その値が履歴として大きいパラメータの更新を抑制する。振動が起こっている時は、本来更新しなくても良い方向に行ったり来たりしてしまっているわけだから、このような過去の更新量に基づく調整が有効に働くことが分かるだろう。
RMSpropのパラメータ更新式は以下の通り (参考)。
この式が示すとおりは、過去の勾配の二乗を時間平均したもので、その平方根の逆数を勾配に乗ずることで、過去に多く更新されているパラメータの更新を抑制している。なお、はゼロ除算を防ぐための定数でPyTorchでは初期値としてが設定されている。
Adam
Adam (adaptive moment estimation)は、前述のMomentum SGDとRMSpropを組み合わせたアルゴリズムで、確率的最急降下法の勾配方向の不安定性と振動の問題を両方解決するように設計されている。
Adamには更新率と合わせて、二つのパラメータとを設定する。これらのうちは、勾配方向に慣性を調整するパラメータで1に近い値を取るほど、強く慣性が働き、過去の勾配の影響を強く残す。一方、は、振動の抑制に働くパラメータで、1に近い値が取るほど、過去の勾配の大きさを考慮して更新量を抑制するようになる。
実際の更新式は以下の通りである (参考)。ただし とする。
がMomentum SGDにおける慣性に、 がRMSpropにおける勾配の二乗の時間平均に対応していることが分かるだろう。
なお、 と はいずれも 0 で初期化されるため、最適化の開始直後には、本来あるべき値よりも 0 に偏った値を取ってしまう。 で割ることによって、この偏りを打ち消す操作をバイアス補正と呼ぶ。 が大きくなると は 1 に近づくので、この補正の効果は最適化が進むにつれて弱まっていく。
オプティマイザを使用した最適化
深層学習では、上記のSGDやAdam等のオプティマイザを用いてニューラルネットワークのパラメータを最適化するのだが、この仕組みは最急降下法等の一階微分を用いる最適化問題にも使用することができる。
そこで、深層学習に進む前に、まずは前述のRosenbrock関数を上記のオプティマイザを使って最適化し、その違いについて見てみよう。
# 比較するオプティマイザのリスト
optims = {
    'SGD': lambda x: torch.optim.SGD([x], lr=2.0e-3),
    'Momentum-SGD': lambda x: torch.optim.SGD([x], lr=2.0e-3, momentum=0.9),
    'RMSprop': lambda x: torch.optim.RMSprop([x], lr=2.0e-3),
    'Adam': lambda x: torch.optim.Adam([x], lr=2.0e-3),
}

# 各オプティマイザの軌跡を保存する
plots = {}
for name, opt in optims.items():
    x = torch.tensor(initial_x, requires_grad=True)
    optim = opt(x)

    history = []
    for i in range(10000):
        # 現在の点を保存
        history.append(x.clone().detach().numpy())

        # パラメータの更新
        y = rosenbrock(x)
        optim.zero_grad()
        y.backward()
        optim.step()

    plots[name] = np.array(history)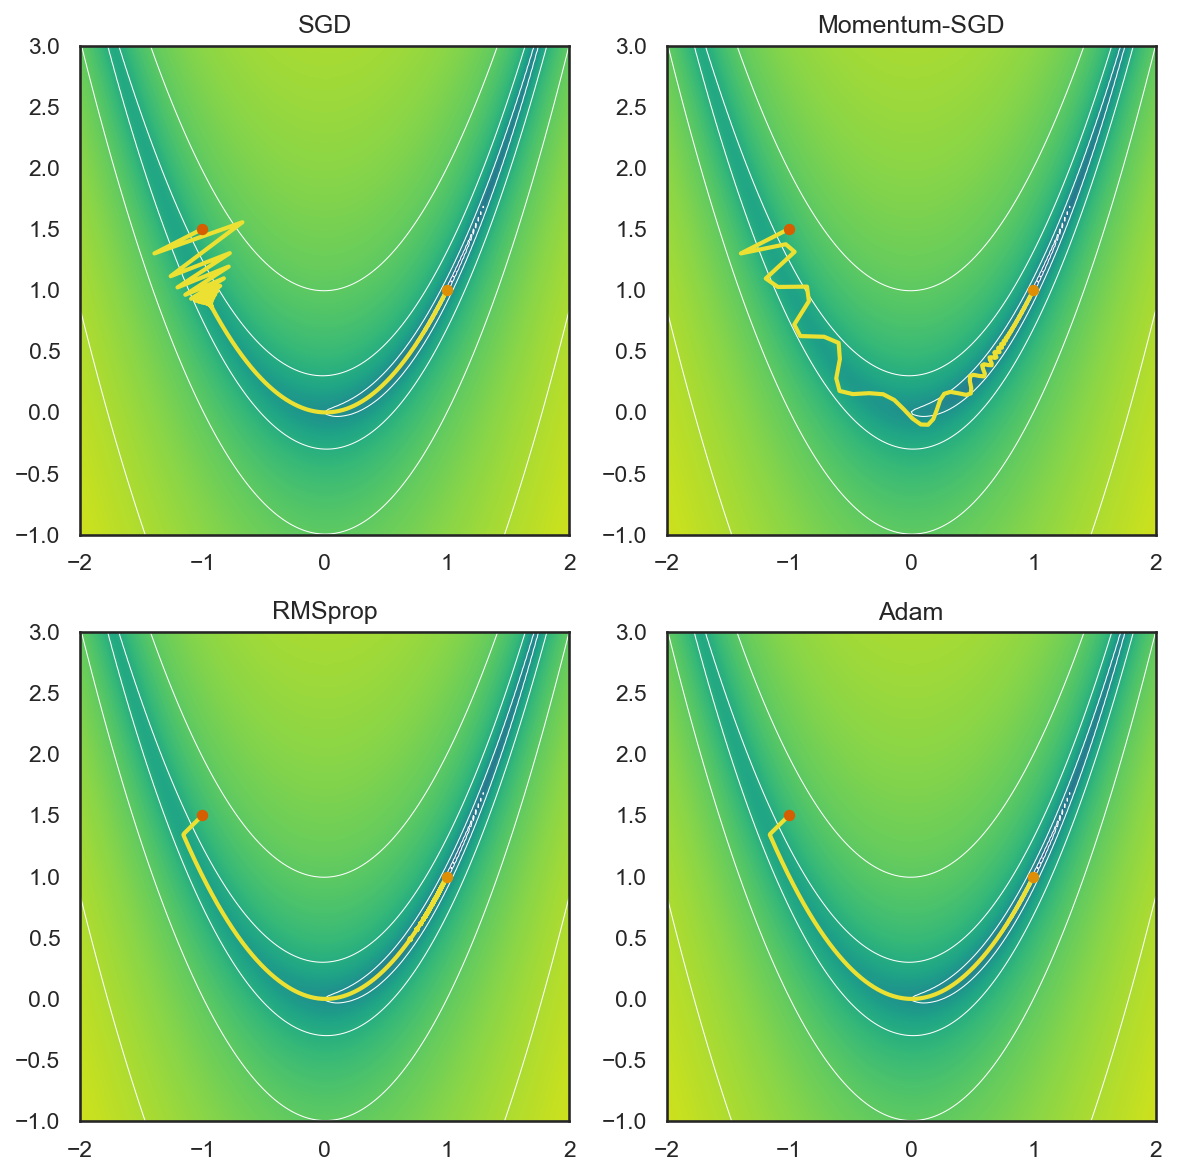
上記の結果を見てみると、SGDは最初の方で、解が大きく振動しているのに対して、Momentum SGDでは、それが多少緩和されていることが分かる。また、更新量から、その勾配を調整する仕組みが入っているRMSpropやAdamでは、ほとんど解が振動することなく、Rosenbrock関数の谷に沿って、解が収束している。
このような、最適化手法の性質の違いに留意しつつ、適切なオプティマイザを選ぶことが好ましい。ただし、オプティマイザに関しては、Adamの発展形などもいろいろと提案されており、新しいものを使おうとすると切りがないため、深層学習を使って研究する場合には、現在、他の多くの研究で用いられているものを使っておくのが無難だろう。
以上で、PyTorchにおけるテンソルの扱い方、自動微分の仕組み、そして自動微分を利用した最適化について一通り見てきた。
次章の深層学習による画像識別では、ここで学んだ内容を土台として、実際にニューラルネットワークを構築し、平仮名の画像を識別するモデルを学習させる。
10.5発展的な内容
ここから先の節は、講義の中では扱わない発展的な内容である。PyTorchの自動微分に、自分で定義した演算を組み込みたい場合に読んでほしい。
発展: 自動微分可能な演算の定義
PyTorchを使うと、自分で微分可能な演算を定義することもできる。関数を定義するための一般的な方法は、torch.autograd.Functionを継承したクラスを定義し、そこに静的メソッドとしてforwardとbackwardの二つの関数を実装するというものである。
forward内で計算済みの変数で、backwardの計算でも使うものはctx.save_for_backward(...)を用いてbackward関数に渡すことができる。変数の取り出しにはctx.saved_tensorsを用いる。以下の例では、を例にとって、実際に微分可能な演算を定義してみる。
from torch.autograd import Function


class MyCosine(Function):
    @staticmethod
    def forward(ctx, x):
        y = torch.cos(x)
        ctx.save_for_backward(x, y)
        return y

    @staticmethod
    def backward(ctx, grad_output):
        x, y = ctx.saved_tensors
return grad_output * (-torch.sin(x))この実装では、forwardの中で、として、戻り値を計算した後に、入力のと出力のの値をsave_for_backward(x, y)としてbackward側でも使えるようにしている。今回の計算では、の微分がであるため、必ずしもをbackward側で使えるようにしておく必要はない。しかし、例えばやシグモイド関数のように、導関数のなかに自分自身を含むようなものも多く、計算量の観点から、forwardでの出力をbackward側で使えるようにしておくことが多い。
このFunction型のサブクラスはMyCosine.applyのように呼び出すことで関数のforwardが呼び出されて、その計算結果が使われた出力においてbackwardが呼び出されると、自動的にMyCosineのbackwardのその計算の中で呼び出されるようになる。
PyTorch内部の実装においては、上記のようなFunctionのサブクラスを内部で呼び出すような関数を定義している場合が多く、それに従ってmy_cos関数を定義しておく。
def my_cos(x):
    return MyCosine.apply(x)
これを用いて、再度 の微分を計算してみると、以下のように正しく計算が行えていることが分かる。
x = torch.tensor([2.0], requires_grad=True)
y = x * x
z = my_cos(y)
z.backward()
print(f'my cosine: dzdx = {x.grad.item():.5f}')
my cosine: dzdx = 3.02721
10.6参考文献
- Fukushima, K. (1980). Neocognitron: A self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position. Biological Cybernetics, 36(4), 193–202. 10.1007/bf00344251
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533–536. 10.1038/323533a0
- Hopfield, J. J. (1982). Neural networks and physical systems with emergent collective computational abilities. Proceedings of the National Academy of Sciences, 79(8), 2554–2558. 10.1073/pnas.79.8.2554
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet Classification with Deep Convolutional Neural Networks. Proceedings of the 25th International Conference on Neural Information Processing Systems, 1097–1105. 10.1145/3065386
- Gulcehre, C., Moczulski, M., & Bengio, Y. (2014). ADASECANT: Robust Adaptive Secant Method for Stochastic Gradient. IEEE International Joint Conference on Neural Network.